11월 19일(현지시간) 오픈AI가 사내 운영 체계인 '퍼포먼스 팩토리'를 공개했습니다. 이름은 거창하지만 하는 일은 분명합니다. 챗GPT 같은 서비스의 성능이 떨어졌다는 알림이 오면, 코덱스 에이전트가 로그와 지표를 뒤져 원인을 찾고 수정 PR까지 만듭니다. 배포 뒤에 성능이 원래대로 돌아왔는지도 확인합니다.
숫자도 함께 공개됐습니다. 석 달이 조금 넘는 기간에 1,700건이 넘는 조사를 추적했고, 600건이 넘는 사례에서 근본 원인을 특정했습니다. 하루 평균 17건을 자동으로 조사한 셈입니다. 성능 회귀 대응이라는, 원래는 사람이 밤새 로그를 보던 일이 조금씩 자동화 쪽으로 넘어가고 있습니다.
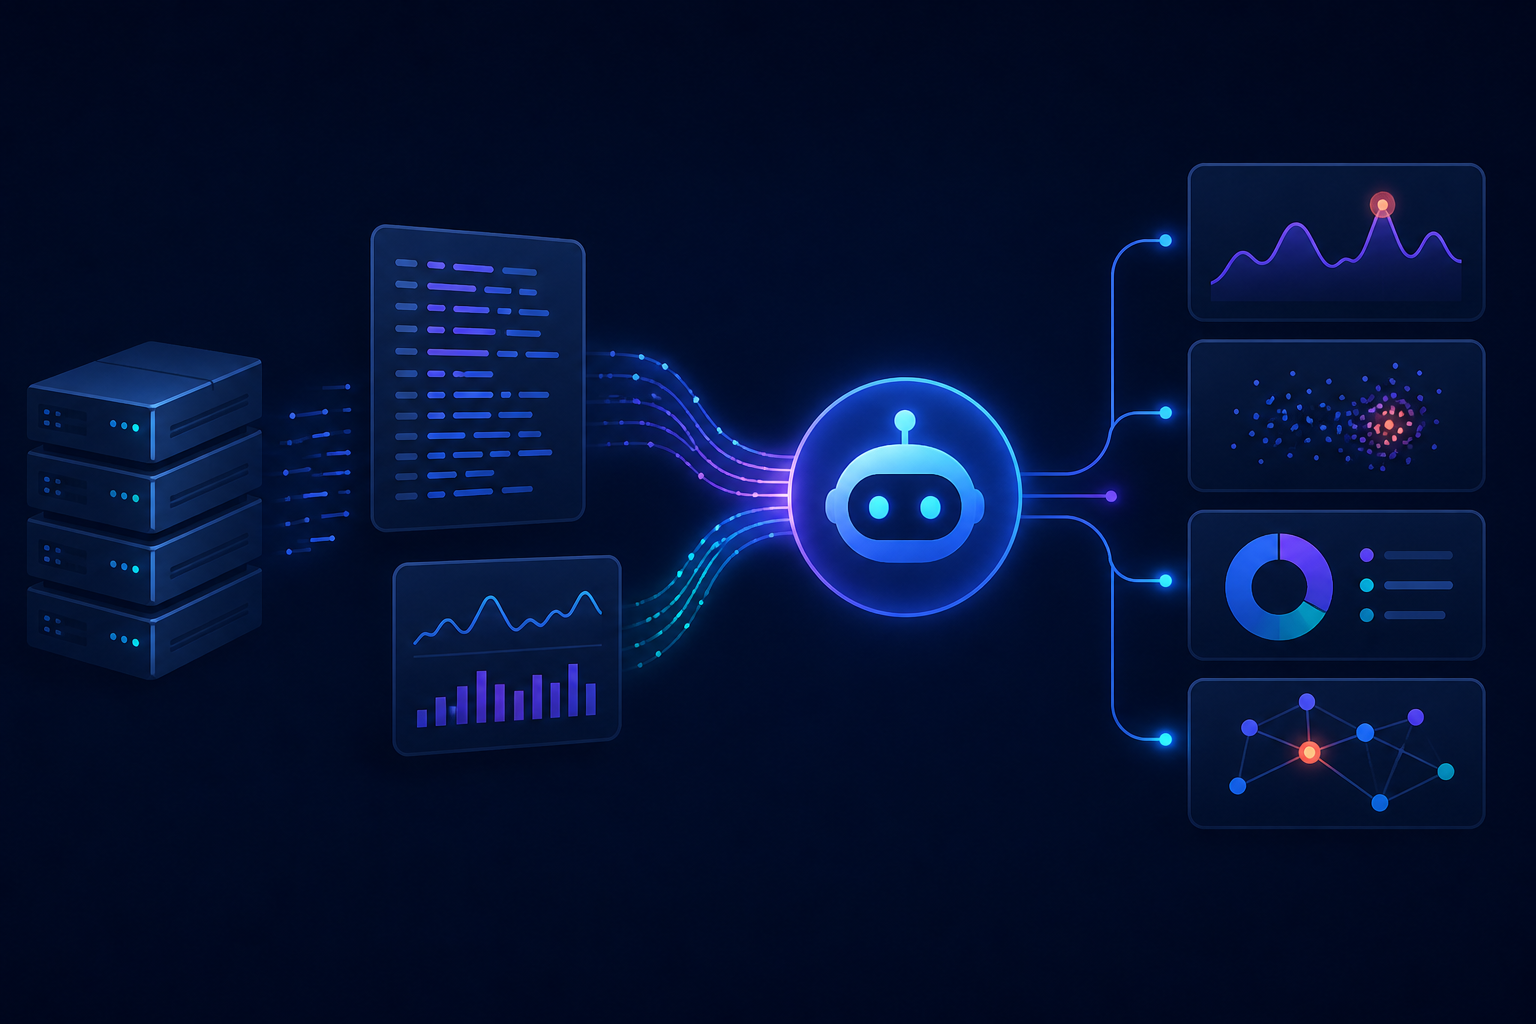
구조는 네 덩어리입니다
퍼포먼스 팩토리는 태스크 관리, 에이전트에 작업을 배정하는 dispatch loop, 클라우드에서 코덱스를 실행하는 API, 그리고 리뷰 코멘트나 배포 완료 같은 이벤트를 받아오는 subscriptions로 구성됩니다. 여기에 흥미로운 장치가 하나 더 붙습니다. 원인 후보를 찾아낸 코덱스 세션과 별개로, 다른 세션이 '반증 역할'을 맡아 전제와 인과관계를 다시 확인합니다.
실무에서 이 반증 단계가 중요한 이유는 명확합니다. 로그를 잘못 읽어서 그럴듯한 가설을 세우는 일은 사람에게도, 모델에게도 흔합니다. 한 번 더 반대편에서 검증하지 않으면, 그 오진이 그대로 PR이 되어 배포됩니다.
사람이 남는 지점을 일부러 남겨 뒀습니다
진단을 통과하면 코덱스가 수정안을 구현해 PR을 만들고, 머지와 배포는 엔지니어가 판단합니다. 오픈AI가 근본 원인 후보 100건을 사람이 직접 평가한 결과는 70%가 정확했고, 30%는 추가 개선이나 인과관계 확인이 필요했습니다.
이 30%가 현업의 핵심입니다. 자동화가 70%를 가져가도 남는 30%는 결국 사람이 봐야 하고, 그 30%가 장애 대응 시간의 대부분을 차지합니다. 그래서 도입 효과는 '조사 건수'가 아니라 '사람이 붙잡고 있던 시간이 얼마나 줄었는지'로 재야 합니다.
권한을 서비스 ID로 분리한 설계
에이전트는 서비스용 ID로 움직입니다. 접근 권한과 실행 주체를 구분해, 에이전트가 무엇을 했는지 추적할 수 있게 했습니다. 사내 시스템에 에이전트를 붙일 때 가장 먼저 무너지는 부분이기도 합니다. 사람 계정을 그대로 넘겨주면 감사 로그가 뒤엉키고, 장애가 났을 때 누가 무엇을 바꿨는지 설명하지 못합니다.
에이전트를 팀원처럼 다루려면 계정부터 팀원처럼 발급해야 합니다. 이건 기술 문제가 아니라 운영 규칙의 문제입니다.
같은 주에 나온 두 번째 신호
허깅페이스는 11월 20일 오픈 모델 큐웬 3.8(27B)을 특정 코딩 에이전트 도구(하네스)에 맞춰 강화학습으로 덧붙여 학습한 '하네스 어댑터'와 학습 데이터·코드를 공개했습니다. 코딩 성공률이 40%에서 64%로 올랐습니다. 더 큰 모델을 찾는 대신, 실제로 쓰는 도구와 과제에 맞춰 소규모로 추가 학습하는 쪽이 비용 대비 효율이 나왔다는 사례입니다.
같은 결의 소식이 하나 더 있습니다. 구글은 제미나이 인터랙션 API에 '도구 검색(Tool Retrieval)'을 미리보기로 추가했습니다. 에이전트에 도구가 수십 개에서 수백 개로 붙으면 매 요청마다 스키마를 전부 넣느라 토큰이 늘고 지연도 생깁니다. 도구 검색은 이름과 설명만 보여주고, 실제로 필요할 때 해당 도구의 전체 스키마를 불러오는 방식입니다. 추가 요금은 없고 제미나이 3.6 이후 모델과 4계열이 지원합니다.
정리하면 이번 주 AI 업계의 공통된 방향은 '더 큰 모델'이 아니라 '쓰는 환경에 맞추기'입니다. 운영은 도구에 맞춰 에이전트를 붙이고, 모델은 도구에 맞춰 조정하고, 도구 정의는 필요할 때만 불러옵니다.
그래서 우리 팀은 무엇부터 해야 할까
첫째, 회귀 대응의 1단계를 에이전트에 넘깁니다. 알림을 받아 로그·트레이스·지표를 모으고 원인 후보를 나열하는 데까지입니다. 판단이 아니라 수집과 정리를 맡기는 것입니다.
둘째, 반증 단계를 만듭니다. 한 세션이 낸 결론을 다른 세션이 검증하는 구조가 없으면 자동화는 오진의 속도만 높입니다.
셋째, 에이전트 전용 계정과 권한을 발급합니다. 읽기 권한과 쓰기 권한을 나누고, 어떤 경로를 건드리면 무조건 사람이 보는지 목록으로 정합니다.
여기에 기준 하나를 더 붙이면 좋습니다. 오픈AI가 11월 18일 공개한 보고서에서는 사람 개입 없이 코딩 에이전트가 끝낸 2~4시간짜리 연구 과제 비율이 3월 23%에서 10월 46%로 두 배가 됐습니다. 다만 분야별 성공률은 79%에서 25%까지 벌어집니다. 평균이 아니라 분포를 봐야 한다는 뜻입니다. 우리 업무에서 어떤 과제가 79% 쪽이고 어떤 과제가 25% 쪽인지 먼저 분류하는 것이 도입 순서입니다.
자동화율보다 확인 지점의 위치
퍼포먼스 팩토리는 'AI가 코드를 쓴다'는 뉴스가 아닙니다. 운영의 일부를 에이전트에게 넘기고, 남는 판단을 사람에게 남겨 둔 설계를 공개한 사례입니다. 자동화율을 올리는 것보다 어디에 사람의 확인 지점을 둘 것인가가 먼저 정해져야 합니다.
오늘 팀 회의에서 정할 것은 모델 선택이 아니라 그 지점의 위치일지도 모릅니다. 조사는 에이전트가, 판단은 사람이. 이 경계를 문서로 남겨 두면 다음 분기에 같은 논의를 반복하지 않게 됩니다.
#오픈AI #퍼포먼스팩토리 #코덱스 #AI에이전트 #허깅페이스 #제미나이 #도구검색 #MLOps
'인공지능 실전' 카테고리의 다른 글
| 수능 끝나고 시작된 AI 이용 기록 추적…현업 AI팀이 지금 점검할 세 가지 (0) | 2026.11.21 |
|---|---|
| 오픈AI 내부 모델이 메일 복사 스크립트를 만들었다, AI 에이전트 실무팀이 다시 볼 3가지 (0) | 2026.11.20 |
| AI 머신러닝 초보자를 위한 필수 개념, 딥러닝 & 신경망 쉽게 이해하기 (0) | 2025.04.05 |
| Stable Diffusion 직접 설치하는 법: AI 그림 생성 모델 구축 가이드 (2025년 최신) (0) | 2025.04.04 |
| GitHub Copilot vs ChatGPT: 코딩 기능 비교 (1) | 2025.04.03 |